在电子游戏里,玩家拥有一项近乎无敌的特权——无限读档(env.reset)。
在机器人仿真环境中,一些具身 Agent 同样可以通过提前探索任务、反复重置环境、修改动作脚本,逐步寻找更优的操作策略。
但如果不给机器人提前刷题的机会呢?
最近,星衍智能推出的通用具身 Harness 框架 Auriga,在不针对目标任务预调优、不依赖专家演示、单次执行且不允许环境重置的 Zero-shot 评测协议下,领跑 RoboDojo 榜单。与此同时,Auriga 还在 RoboCasa365 Target50 评测中,凭借同一套 Harness 框架取得领先表现。
没有提前刷题,却能超越部分有备而来的对手。Auriga 是怎么做到的?
答案或许不在于记住更多任务的标准答案,而在于构建一套能够跨任务复用的物理执行系统。这也引出了一个更深层的问题:机器人究竟是在优化一道题的答案,还是在进化解决问题的能力?
1. 具身 RSI 的三个层次:
机器人能力的进化,关键不在于经历了多少次试错,而在于每次改进究竟改变了什么:是当前任务的解决方案、一次执行中的操作策略,还是能够被未来不同任务复用的系统能力?
基于这一视角,星衍智能将 Physical RSI 的发展路径归纳为三个层次:
L1:任务级搜索,即进化答案。系统通过反复重置环境、修改动作脚本或调整控制参数,为特定任务寻找更优解。它能够不断提升当前任务的表现,但往往需要为新任务重新优化。
L2:单次在线适应,即进化过程。系统不再依赖反复重置,而是在一次连续执行中,根据观测和反馈调整动作。改进发生在当前任务的执行过程中,但这些调整不一定会沉淀为可供其他任务使用的通用能力。
L3:系统级能力改进,即进化系统。系统从不同任务的交互中识别反复出现的共性问题,并进一步改进底层通用工具、控制原语或技能机制。与 L2 不同,这些改进会被保留在系统中,供后续不同任务调用,并通过新的任务验证其迁移价值。
从 L1 到 L3,改变的不只是试错方式,更是能力改进的范围:从一道题的答案,到一次执行的过程,再到一套能够应对不同问题的系统。
星衍智能 Auriga 选择从 L3 所代表的系统级通用能力出发:不为每个新任务重新定制策略,而是让同一套 Harness 支撑不同物理任务中的感知、执行与在线纠错。
真正的进化,不是让机器人记住越来越多的答案,而是让它拥有一套不必为每道新题重新发明的解题系统。
为大语言模型构建通往物理世界的通用 Harness
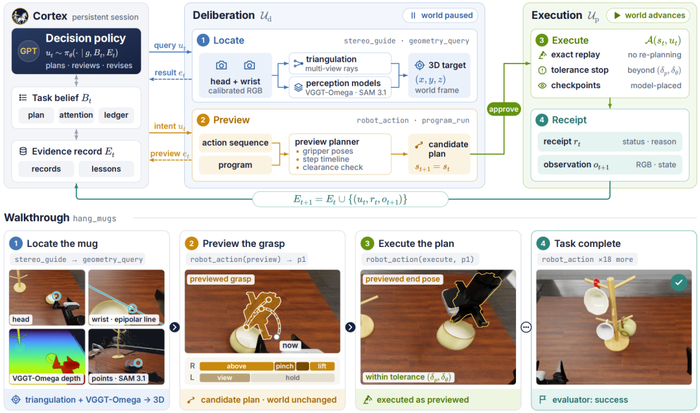
Auriga 是星衍智能研发的通用具身 Harness 框架,将物理感知、动作表达、执行验证与任务状态管理整合为统一的交互系统,支持大语言模型在陌生任务中自主规划、执行与在线恢复。
在这一架构中,模型主导任务决策,Harness 提供可量化的物理状态、完整的动作表达与可验证的执行过程,让高层推理能够转化为连续的机器人操作。
系统架构围绕三个核心能力展开:
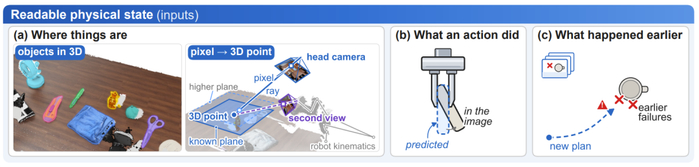
感知即测量(Perception as Measurement): 融合三维重建、视觉分割与机器人运动学,将图像转化为具有真实物理尺度、可查询和验证的空间信息。

访谈
更多上海推进工业垂类大模型与具身智能深度融合
上海正加速推动工业垂类大模型与具身智能技术的深度结合,旨在重塑高端制造的价值创造逻辑。张江科学城依托…
邓中亮院士团队推进5G+北斗融合定位技术
低空经济作为新质生产力的重要引擎,对时空信息服务体系提出了全新要求。中国工程院院士邓中亮指出,随着无…
箭牌卢金辉解读行业拐点:智能家居下半场核心是“懂人”
2026 年的秋天,两个标志性信号,共同划定了中国家居产业的周期拐点。九月,商务部等八部门联合印发《促进…